 TensorFusion 文档
TensorFusion 安全白皮书
本文说明 TensorFusion 的安全设计:各组件运行在哪里、需要哪些权限、分析过哪些威胁以及各自缓解到什么程度、哪些数据会离开集群。读者是需要评审或加固部署方案的安全人员和平台管理员。
先说结论:
- 核心组件全部运行在你的集群内,不需要从公网访问集群的入站连接。
- Hypervisor 是特权节点代理。Controller 的集群权限较大,但没有集群范围的 Secret 访问权限。
soft隔离用来在互相配合的工作负载之间执行配额,不是防范恶意租户的安全边界。面对不受信任的租户,请使用partitioned隔离、远程 vGPU 或独立节点。- Cloud 控制台是可选的。启用后,它通过集群主动发起的 WebSocket 访问集群,使用的是 Controller 的 ServiceAccount。
1. 系统概述
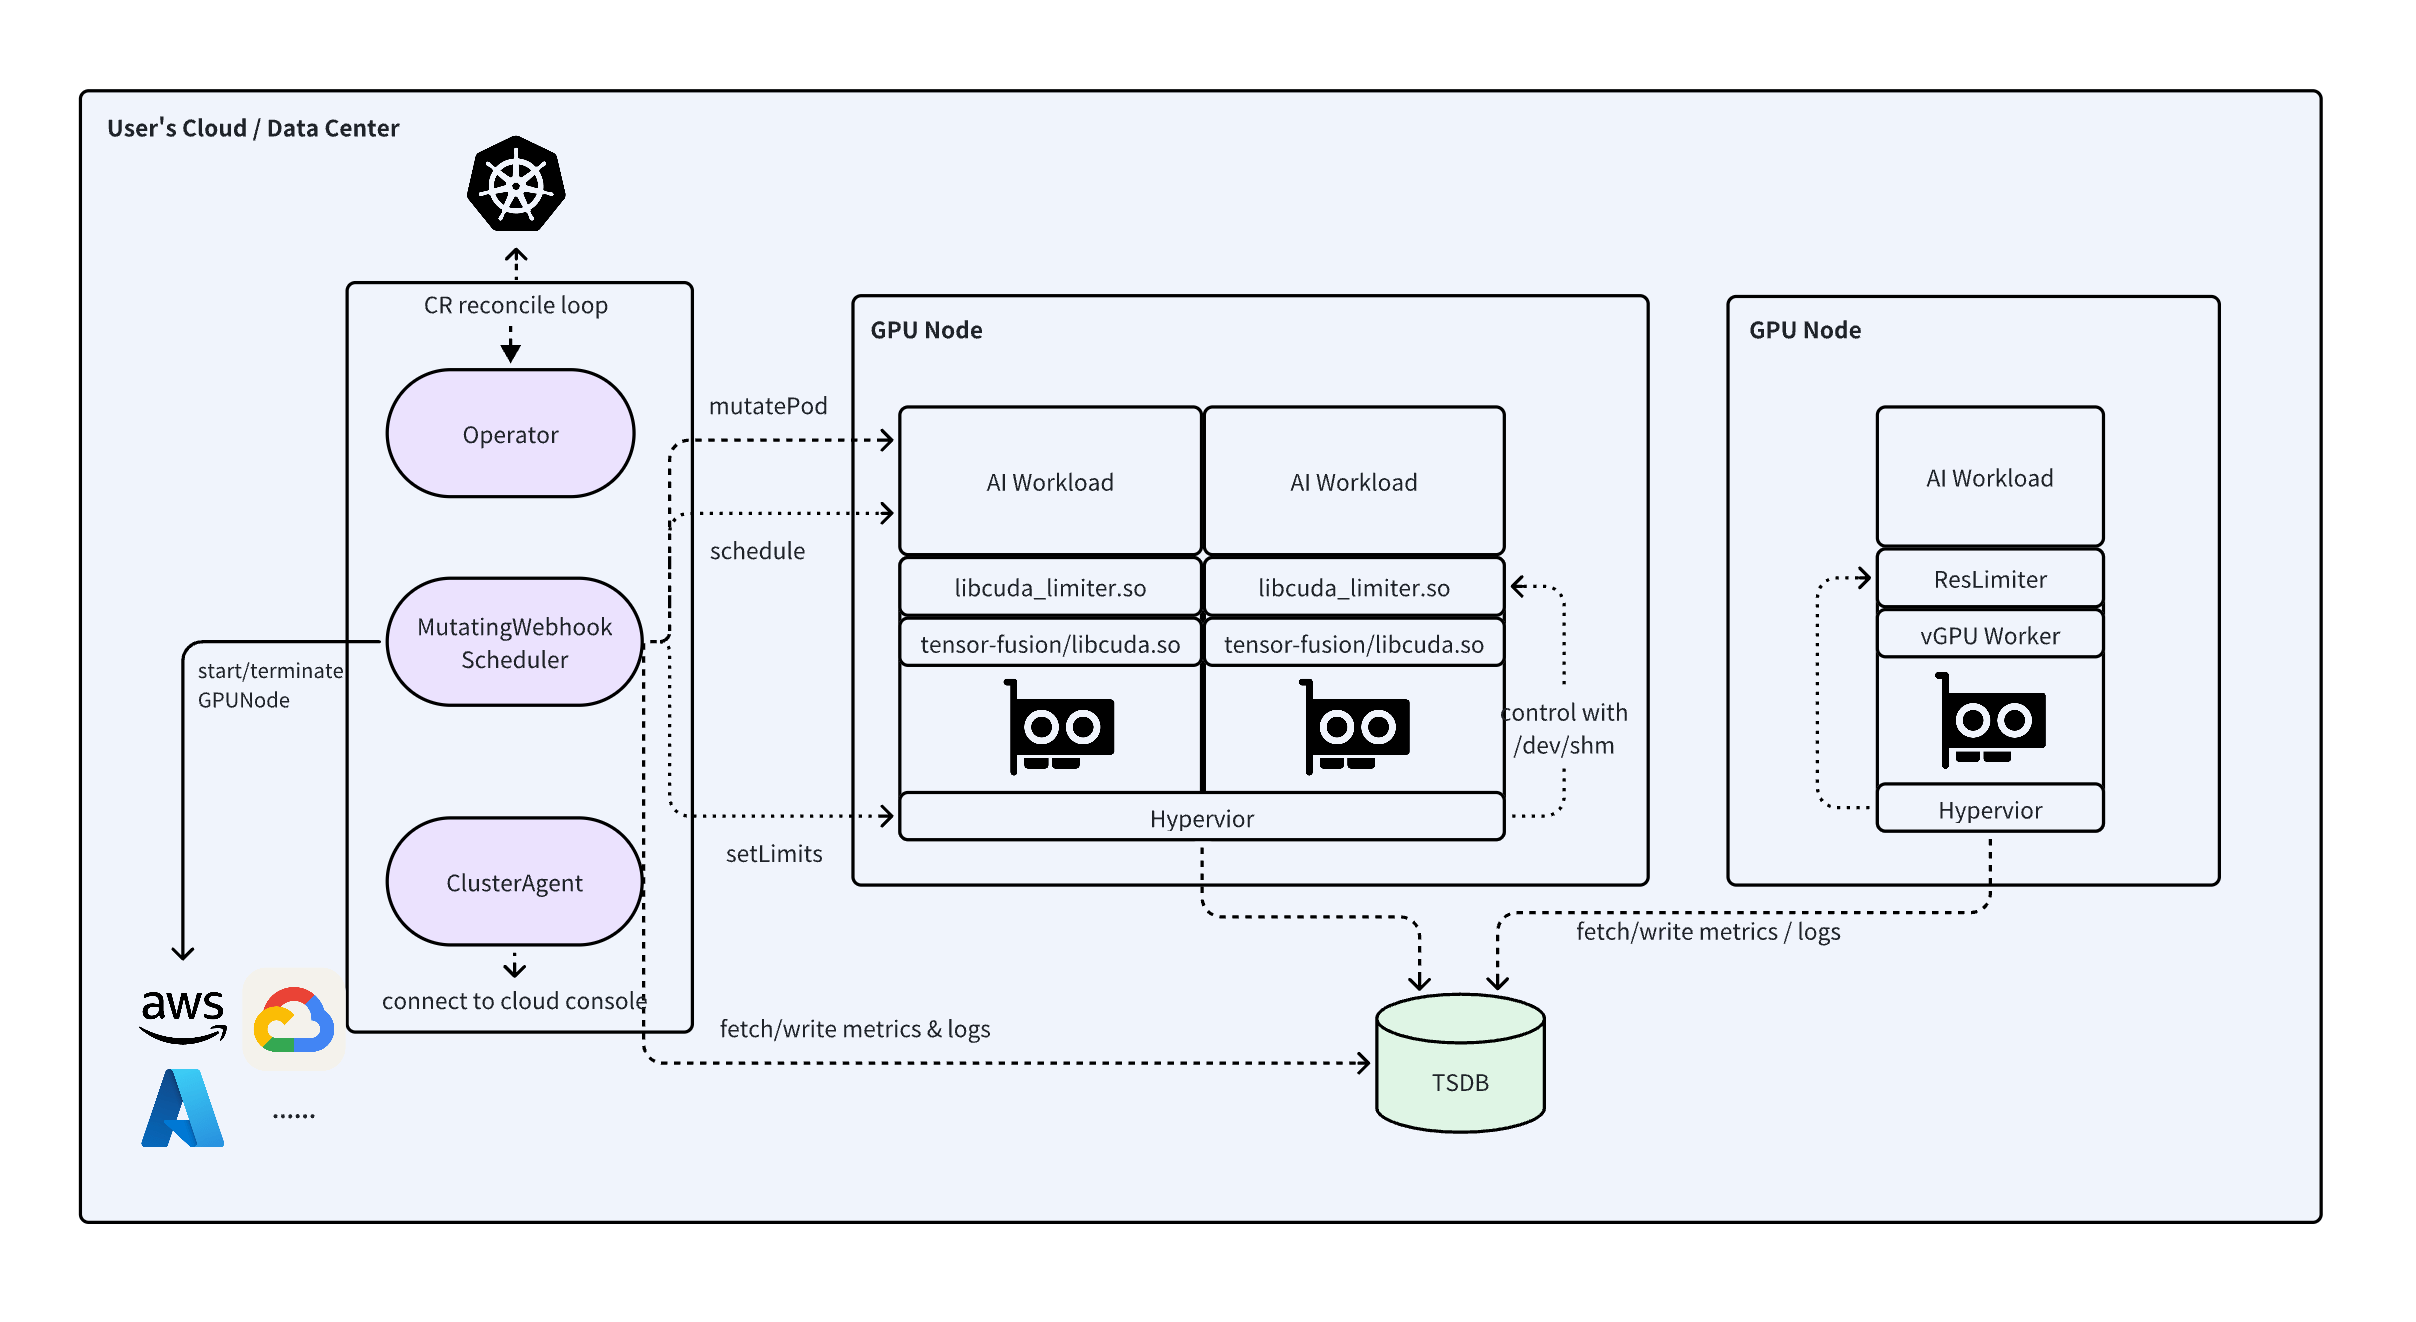
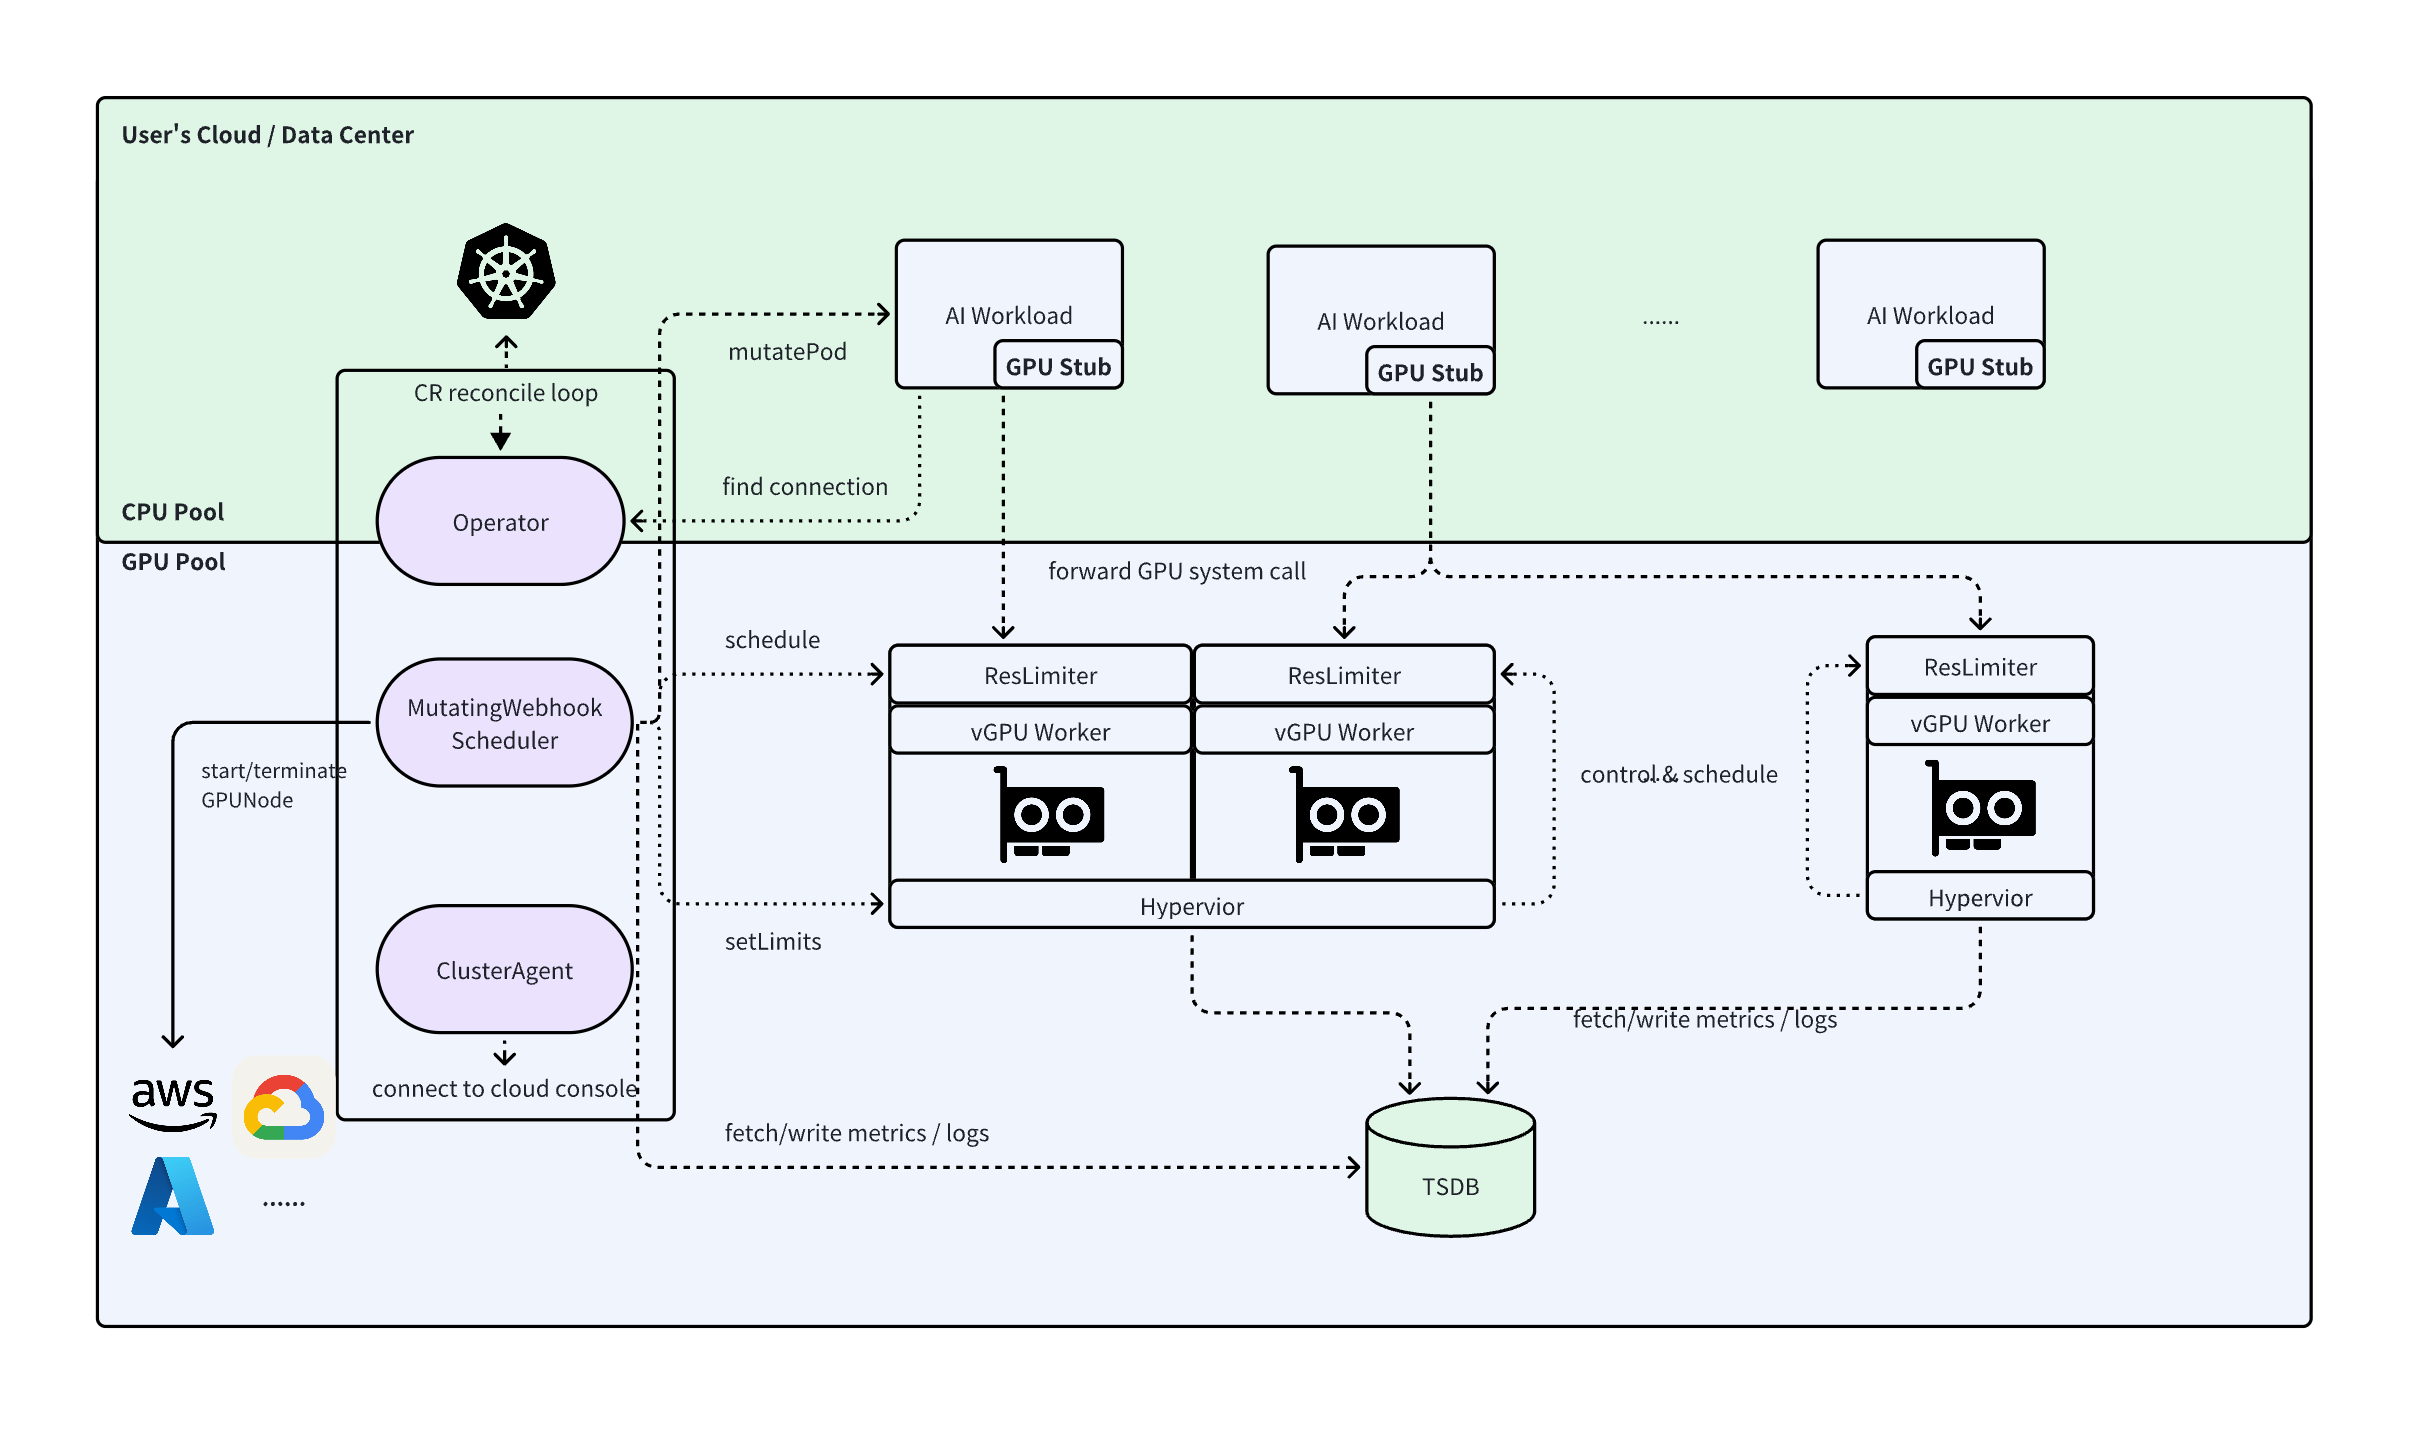
1.1 架构
本地 vGPU
远程 vGPU
范围:本威胁模型覆盖下面列出的 TensorFusion 组件。时序数据库、GPU 驱动、容器运行时,以及运行在上面的 AI 框架和模型不在范围内。
目标:找出 TensorFusion 可能被用来滥用 GPU 资源、突破租户边界,或渗透所在集群和数据中心的途径。
1.2 组件
| 组件 | 运行位置 | 职责 |
|---|---|---|
| Controller | TensorFusion 命名空间里的 Deployment | 一个进程,包含 CRD 控制器、Pod mutating webhook、调度器、告警评估、指标记录和 HTTP API。 |
| Hypervisor | 每个 GPU 节点一个 Pod,由 Controller 创建 | 通过厂商库发现设备,充当 device plugin,把每个 Pod 的限额写入共享内存,并上报用量。 |
| Limiter | 业务容器内的库(soft 隔离) | 在业务进程内拦截 GPU 调用,按 Hypervisor 下发的限额执行。 |
| 客户端库 | 业务容器内的库(远程 vGPU,或带 worker 的本地模式) | 把 GPU 调用转发给 worker。 |
| Worker | 业务 Pod 里的 sidecar,或 GPU 节点上的独立 Pod | 在物理 GPU 上执行转发来的调用,并执行 hard 限额。 |
| Vector | Controller 的 sidecar,Hypervisor 可选启用 | 把指标和组件日志发送到 GreptimeDB。 |
| Cluster agent | Controller 的可选 sidecar | 把集群接入 Cloud 控制台。只有设置了 agent.agentId 才会部署。 |
Controller、Hypervisor 和 limiter 是开源的。客户端库和 worker 以容器镜像形式分发。
1.3 权限
Controller 的 Kubernetes RBAC
Controller 使用一个 ClusterRole。来源:rbac.yaml。
| 资源 | 权限 | 用途 |
|---|---|---|
所有 tensor-fusion.ai 资源 | 全部 | 核心功能。 |
| Pod、Node | 全部,包括 pods/binding、pods/eviction、pods/status、nodes/status | 调度、绑定、节点生命周期管理、碎片整理。 |
| Deployment、StatefulSet、DaemonSet、ReplicaSet、Job | 全部 | 创建 Hypervisor、worker Pod 和驱动探测 Job;迁移已有工作负载。 |
| ConfigMap、Event、Namespace | 读写 | 配置、记录事件、命名空间级配额。 |
pods/exec | 创建 | 只有 Cloud 控制台的网页终端会通过 cluster agent 用到。不用这个功能可以删除。 |
karpenter.sh 资源 | 全部 | 由 Karpenter 供给 GPU 节点时创建 NodeClaim。不用 Karpenter 可以删除。 |
tokenreviews、subjectaccessreviews | 创建 | 校验发给 Controller HTTP API 的 ServiceAccount token,以及对指标端点的访问做鉴权。 |
| Lease | 全部 | 选主。 |
| PV、PVC、StorageClass、CSI 对象、PDB、DRA 资源、Service | 只读(PV、PVC 和 ResourceClaim 另有更新权限) | 内嵌的 Kubernetes 调度器需要。 |
这个 ClusterRole 不包含任何 Secret 权限。Controller 只能读到挂载进自身 Pod 的 Secret:webhook 的 TLS 证书、供给节点用的云厂商凭据,以及使用 GreptimeDB Cloud 时的数据库密码。
Hypervisor 的 Kubernetes RBAC
| 资源 | 权限 | 用途 |
|---|---|---|
| Node、Pod、Namespace | 只读 | 找到所在节点上的 Pod。 |
gpus、gpunodes 及其 status、providerconfigs | 读取、创建、更新、删除 | 上报设备,清理已不存在的 GPU。 |
tokenreviews | 创建 | 校验调用 Hypervisor 的 limiter 或 worker 所带的 Pod token。 |
节点级权限
Hypervisor 需要深入访问节点。安装前请逐项评审:
| 权限 | 位置 | 用途 |
|---|---|---|
hostNetwork | Hypervisor Pod | 业务 Pod 通过节点 IP 访问 Hypervisor。 |
hostPID 和 SYS_PTRACE 能力 | Hypervisor Pod | 把 /proc 里的 GPU 进程对应到所属的 Pod。 |
privileged: true,以 root 运行 | Hypervisor 容器(chart 默认模板)及其 init 容器 | 挂载共享内存用的 tmpfs、把厂商库复制到宿主机、访问设备。 |
| AppArmor 不设限(Unconfined) | Hypervisor 容器,Kubernetes 1.30 及以上 | 写共享内存、读 /proc。 |
宿主机路径 /run/tensor-fusion、/var/lib/kubelet/device-plugins、/var/lib/kubelet/pod-resources | Hypervisor Pod | 共享内存和厂商库;注册 device plugin;获取 Pod 与设备的对应关系。 |
宿主机路径 /var/log/pods | Vector sidecar | 采集组件日志。 |
| 访问节点上的所有 GPU | Hypervisor Pod | 设备发现和指标采集。 |
业务 Pod 不会获得额外权限。soft 隔离的 Pod 只多出两样东西:自己的共享内存目录 /run/tensor-fusion/shm/<namespace>/<pod> 的挂载,和一个生成的 /etc/ld.so.preload。worker 容器不预设自己能看到哪些 GPU,由 Hypervisor 的 device plugin 只交给它调度器分配的那些。
1.4 配置对象
| 对象 | 内容 |
|---|---|
ConfigMap <release>-config | config.yaml(动态配置:指标、告警规则、自动迁移)和 scheduler-config.yaml(格式为 KubeSchedulerConfiguration)。见 Helm 配置项。 |
ConfigMap tensor-fusion-sys-public-gpu-info | GPU 型号目录,含各型号的 TFLOPS 和价格。 |
ConfigMap tensor-fusion-sys-vector-config | Controller 和 Hypervisor 的 Vector 采集配置。 |
MutatingWebhookConfiguration(名称以 -mutating-webhook 结尾) | 拦截 Pod 创建。默认只选中带 tensor-fusion.ai/enabled=true 标签的 Pod,失败策略为 Fail。 |
Secret tensor-fusion-webhook-secret | webhook 服务的 TLS 证书。安装时由 kube-webhook-certgen Job 生成,Job 成功后自动删除。 |
Secret tf-cloud-vendor-credentials | 供给节点用的云厂商访问密钥,来自 Helm 的 cloudVendorCredentials。不通过 TensorFusion 供给节点时为空。 |
Helm values 文件里可能有凭据(cloudVendorCredentials、greptime.password、agent.enrollToken),请按密钥的标准保管。
1.5 已有的安全控制
GPU 虚拟化层
- 远程 vGPU 的进程分离:TensorFusion 不给业务容器分配 GPU 设备。GPU 调用由另一个容器里的 worker 执行,算力和显存限额也在那里执行。
- 硬件分区:
partitioned模式下,每个工作负载拿到的是厂商强制隔离的分区,例如 NVIDIA MIG 实例。 - 查询 worker 地址需要认证:客户端必须出示所在 Pod 的 ServiceAccount token 才能拿到 worker 地址,Controller 会向 Kubernetes API 校验(见 TM02)。
- limiter 注册需要认证:limiter 或 worker 用 Pod token 向 Hypervisor 表明身份。Hypervisor 用
TokenReview校验,并且只用校验得到的 Pod UID 查询限额(见 TM03)。 - 共享内存按 Pod 隔离:每个 Pod 只挂载自己的共享内存目录,看不到其他 Pod 的目录。
编排调度层
- 命名空间配额(
GPUResourceQuota)按命名空间和单个工作负载限制算力、显存和 worker 数量。 - Admission webhook 通过 TLS 提供服务,并用标签限定作用范围。
- Controller 和 Hypervisor 使用各自的 ServiceAccount。Hypervisor 的角色只涉及它自己的资源类型。
- 没有任何组件需要来自集群外的入站连接。
Cloud 控制台
- Cluster agent 主动向控制台建立 TLS 加密的 WebSocket,集群不对外暴露任何端点。
- Agent 只转发白名单内的请求路径:不涉及 Secret 的 Kubernetes API 路径、指标查询和终端代理。
- Agent 可以完全不部署,此时 TensorFusion 与控制台没有任何连接。
2. 威胁模型
2.1 资产
- A1:GPU 硬件及其分配状态
- A2:客户端、limiter 和 worker 使用的 ServiceAccount token
- A3:Controller 和 Hypervisor 的 Kubernetes API 凭据
- A4:TensorFusion 所管理集群中的用户工作负载
- A5:TensorFusion 的配置,包括云厂商凭据
- A6:指标和组件日志
- A7:控制台登录会话
- A8:Agent 的注册 token
2.2 威胁来源
- 外部攻击者:接触到暴露的 API,试图滥用 GPU 资源或读取工作负载数据。
- 恶意租户:拥有某个命名空间的合法权限,试图突破配额、影响其他租户或提升权限。
- 供应链攻击者:通过依赖或容器镜像把代码带进集群运行。
2.3 STRIDE 分类参考
| 威胁类型 | 破坏的属性 | 定义 |
|---|---|---|
| 身份欺骗(Spoofing) | 真实性 | 冒充其他身份或实体 |
| 篡改(Tampering) | 完整性 | 修改磁盘、网络或内存中的数据 |
| 否认(Repudiation) | 不可否认性 | 否认做过某个操作 |
| 信息泄露(Information Disclosure) | 机密性 | 未经授权获取信息 |
| 拒绝服务(Denial of Service) | 可用性 | 耗尽提供服务所需的资源 |
| 权限提升(Elevation of Privilege) | 授权 | 未经授权执行操作 |
2.4 威胁分析
| 编号 | 威胁 | 状态 |
|---|---|---|
| TM01 | 跨租户访问 GPU 显存或绕过配额 | 取决于隔离模式 |
| TM02 | 伪造远程 vGPU 连接请求 | 已缓解 |
| TM03 | 篡改 Hypervisor 与 Pod 之间的通信 | 身份方面已缓解;限额完整性见 TM01 |
| TM04 | 滥用 TensorFusion 的 Kubernetes 权限 | 部分缓解 |
| TM05 | 篡改 admission webhook | 已缓解 |
| TM06 | 耗尽 GPU 资源 | 已缓解 |
| TM07 | 窃听组件间流量 | 部分缓解 |
| TM08 | 供应链被攻破 | 部分缓解 |
TM01:跨租户 GPU 访问和配额绕过(Tampering、Information Disclosure、Elevation of Privilege)
租户试图读取其他租户的 GPU 显存,或者使用超出分配的算力和显存。
一次 GPU 调用经过的路径:
各隔离模式能提供什么:
| 模式 | 限额在哪里执行 | 能否防范恶意租户 |
|---|---|---|
shared | 不执行,Pod 独占整张 GPU。 | 不适用 |
soft | 业务进程内的 limiter | 不能。限额生效的前提是进程保持加载 limiter。 |
hard | Worker 进程 | 限额在业务进程之外执行。 |
partitioned | GPU 硬件和驱动(例如 MIG) | 能,强度取决于厂商的分区机制。 |
| 远程 vGPU | 独立 Pod 里的 worker | 业务容器不会被分配 GPU 设备。 |
缓解措施:
- 远程和
hard工作负载的限额在 worker 里执行,worker 与业务进程是不同的进程。 partitioned模式把隔离交给硬件厂商。- 容器能看到哪些 GPU 由 Hypervisor 决定,不由工作负载决定。
状态:远程 vGPU 和 partitioned 已缓解;本地 soft 隔离部分缓解。
残余风险:soft 隔离的 limiter 运行在租户自己的进程里,能控制这个进程的租户可以绕开它。soft 隔离适合互相信任的工作负载,例如同一组织内的多个团队;对不信任的租户,请使用其他模式或独立节点。对同一张 GPU 上的不同进程,TensorFusion 不会在 GPU 驱动之外额外提供显存隔离。
TM02:伪造远程 vGPU 连接请求(Spoofing、Elevation of Privilege)
没有授权的客户端向 Controller 索要 worker 地址,想占用别人分配到的 GPU。
缓解措施:
- 客户端必须出示所在 Pod 的 ServiceAccount token,Controller 用 Kubernetes
TokenReview校验。 - token 绑定的 Pod UID 必须等于所请求的
TensorFusionConnection的所有者。其他 Pod 的有效 token 会被拒绝。 - 校验结果按 token 和所有者缓存 30 分钟,减轻 API Server 的压力。
状态:已缓解。
TM03:篡改 Hypervisor 与 Pod 之间的通信(Spoofing、Tampering、Information Disclosure)
某个进程在与 Hypervisor 通信时冒充别的 Pod,或者读取别的 Pod 的限额数据。
缓解措施:
- limiter 或 worker 向 Hypervisor 注册时带上 Pod token。Hypervisor 用
TokenReview校验,Pod 身份取自校验结果,不取自请求参数。 - 每个 Pod 只挂载共享内存 tmpfs 下属于自己的子目录。
- tmpfs 由专门的 init 容器创建,目录由 Hypervisor 管理。
状态:身份冒充和读取其他 Pod 数据已缓解。Pod 能否无视自己的限额见 TM01。
TM04:滥用 TensorFusion 的 Kubernetes 权限(Spoofing、Elevation of Privilege)
攻击者攻破 Controller 或某个 Hypervisor 后,用它的 ServiceAccount 操作集群。
缓解措施:
- Controller 没有 Secret 的 RBAC 权限。
- Hypervisor 的角色只包含它自己的自定义资源、Node/Pod/Namespace 的只读权限和
TokenReview。 - 可选权限(
pods/exec、karpenter.sh)在不使用对应功能时可以删除。
状态:部分缓解。
残余风险:Controller 内嵌调度器,并管理节点和工作负载,所以角色范围较大:它可以在全集群创建、修改、删除 Pod 和工作负载控制器。Hypervisor 在每个 GPU 节点上以特权运行。请把两者当作集群关键组件对待:限制谁能修改 TensorFusion 命名空间、其中的 Deployment 和 ConfigMap,以及 GPUPool 里的 Pod 模板。
TM05:篡改 admission webhook(Tampering、Elevation of Privilege)
攻击者修改 webhook 配置以跳过注入,或者冒充 webhook 服务篡改 Pod spec。
缓解措施:
- API Server 通过 TLS 调用 webhook,并用 webhook 配置里的 CA bundle 校验证书。
- 证书保存在 TensorFusion 命名空间的专用 Secret 里。
- webhook 只处理带
tensor-fusion.ai/enabled=true标签的 Pod(开启自动迁移时除外),出故障不会影响其他工作负载。 - 失败策略是
Fail:webhook 不可用时,TensorFusion 的 Pod 会被拒绝,而不是不带限额就放行。 - 修改
MutatingWebhookConfiguration需要集群管理员级别的 RBAC 权限,由集群管理员控制。
状态:已缓解。
TM06:耗尽 GPU 资源(Denial of Service、Elevation of Privilege)
某个租户申请远超应得的 GPU 资源,让其他租户拿不到资源。
缓解措施:
GPUResourceQuota限制每个命名空间的 requests 总量、limits 总量和 worker 数量,以及单个工作负载的上限。- 资源紧张时,QoS 等级决定工作负载之间的优先级。
- 分配失败次数和用量都有指标,可以据此配置告警。
状态:已缓解。
TM07:窃听组件间流量(Information Disclosure)
攻击者在集群网络上抓取组件之间的流量。
| 通道 | 保护方式 |
|---|---|
| API Server 到 webhook | TLS |
| 各组件到 Kubernetes API | TLS,ServiceAccount token |
| Cluster agent 到 Cloud 控制台 | TLS(WSS),注册 token |
| 浏览器到 Cloud 控制台 | TLS |
| 客户端库到 Controller、limiter 到 Hypervisor | 集群内 HTTP,请求带 ServiceAccount token |
| 客户端库到远程 worker | 应用层不加密 |
| Vector 到集群内的 GreptimeDB | 集群内 HTTP |
状态:部分缓解。
残余风险:TensorFusion 不对集群内的通道加密。如果你的威胁模型包含 Pod 网络上的攻击者,请开启 CNI 的透明加密或使用服务网格,并用 NetworkPolicy 和节点防火墙限制对 Controller(8080 端口)和 Hypervisor(8001 端口)API 的访问。
TM08:供应链被攻破(Tampering、Elevation of Privilege)
攻击者通过依赖或容器镜像植入恶意代码。
缓解措施:
- Dependabot 为 Go 模块、GitHub Actions 和基础镜像提交更新。
- FOSSA 扫描开源依赖的许可证合规性。
- 发布镜像由 GitHub Actions 工作流构建,镜像仓库凭据保存在 GitHub Secrets 里。
- Controller、Hypervisor 和 limiter 的源码公开,可以审计,也可以自行构建。
状态:部分缓解。
残余风险:默认 chart 对部分第三方镜像使用 latest 这类可变标签。生产环境请把镜像同步到自己的镜像仓库,并按 digest 固定。
3. 数据隐私
3.1 完全私有化部署
不部署 cluster agent 时,除 3.4 节说明的匿名遥测(可以关闭)外,TensorFusion 不会连接任何由 TensorFusion 运营的服务。
- GPU 调用在内存中处理。本地 vGPU 的调用不出节点;远程 vGPU 的调用(包括其中的张量数据)在你内网里的客户端 Pod 和 worker Pod 之间传输。
- TensorFusion 落盘保存的只有指标和组件日志,存放在你配置的 GreptimeDB 实例里。
- TensorFusion 不保存模型权重、提示词或推理结果,也不会把它们发到集群之外。
3.2 启用 Cloud 控制台
启用 agent 后,你所在组织的控制台用户可以按各自的角色查看和管理集群。
这对你意味着:
- 控制台的权限等同于 Controller 的权限:Agent 用 Controller 的 ServiceAccount 调用 Kubernetes API,所以这个 ServiceAccount 能做的事控制台都能做,被 agent 拦截的路径除外。Secret 相关路径会被拦截。
- 数据按需读取:资源状态和指标是在用户打开页面时从你的集群读取的,指标本身留在你的 GreptimeDB 里。
- 控制台保存账号类数据:包括用户、组织、环境注册信息、计费记录和审计记录。
- 断开连接由你控制:从 Helm values 里去掉
agent.agentId并升级 release,连接即断开。
3.3 哪些数据会离开集群
| 数据 | 去向 | 什么时候 |
|---|---|---|
| 控制台用户请求的 Kubernetes 资源状态 | Cloud 控制台,经 agent 的 WebSocket | 仅在启用 agent 时 |
| 从控制台发起的指标和日志查询结果 | Cloud 控制台,经 agent 的 WebSocket | 仅在启用 agent 时 |
| 匿名遥测(见 3.4) | PostHog,us.i.posthog.com | 除非关闭 |
| 指标和日志 | 你的 GreptimeDB Cloud 实例 | 仅在设置了 greptime.isCloud 时 |
3.4 匿名遥测
按设计,每个 Hypervisor 最多每 24 小时向 PostHog(us.i.posthog.com)发送一条匿名使用事件,内容包括:
- 节点的算力总量、显存总量、主机内存,以及 GPU 数量
- GPU 厂商和一个 GPU 型号样本
- worker 数量和隔离模式
- TensorFusion 版本、产品版本类型、运行时长、操作系统和 CPU 架构
事件里没有节点名、IP 地址、命名空间、Pod 名称、工作负载数据或账号标识。
要关闭遥测,通过 GPUPool 的 Hypervisor Pod 模板,给 Hypervisor 容器设置环境变量 DISABLE_TENSOR_FUSION_TELEMETRY,值任意。
4. 加固清单
- 只让集群管理员拥有 TensorFusion 命名空间、
TensorFusionCluster、GPUPool、ProviderConfig资源和 Helm values 的写权限。 - Controller Service 保持 ClusterIP 类型。加一条 NetworkPolicy,只允许运行 TensorFusion 工作负载的命名空间访问 8080 端口。
- Hypervisor 端口(8001)只对节点自身和 Pod 网段放行。
- 为每个租户命名空间创建
GPUResourceQuota。 - 按信任程度选隔离模式:信任边界之内用
soft;跨信任边界用partitioned、远程 vGPU 或独立节点。 - 不使用控制台终端或 Karpenter 时,从 ClusterRole 里删除
pods/exec和karpenter.sh规则。 - 把镜像同步到自己的镜像仓库,并按 digest 固定。
- Pod 网络流量需要保密时,开启 CNI 或服务网格的加密。
- 如果策略不允许对外的管理连接,把
agent.agentId留空,并关闭遥测。
报告漏洞
发现安全问题请不要提公开 issue,按 SECURITY.md 里的流程报告。
结论
TensorFusion 的控制面和数据面都在你的集群内;发放 GPU 访问权的调用用 Kubernetes ServiceAccount token 认证;Controller 的 RBAC 里没有 Secret 权限。主要的取舍前文都已写明:Hypervisor 以特权运行,Controller 的角色范围较大,集群内流量默认不加密,soft 隔离是面向互相配合的工作负载的配额机制。按第 4 节做好加固,并根据租户之间的信任程度选择隔离模式,TensorFusion 可以支撑多团队共享的 GPU 集群。